环境
Mac Mini。teamlead 配置,原生 Hermes gateway,Hermes 专用 Magpie key,低推理,并带上正常 Hermes 上下文与工具定义。
方法
实测笔记 · 2026-10-27
Hermes / time-to-first-text
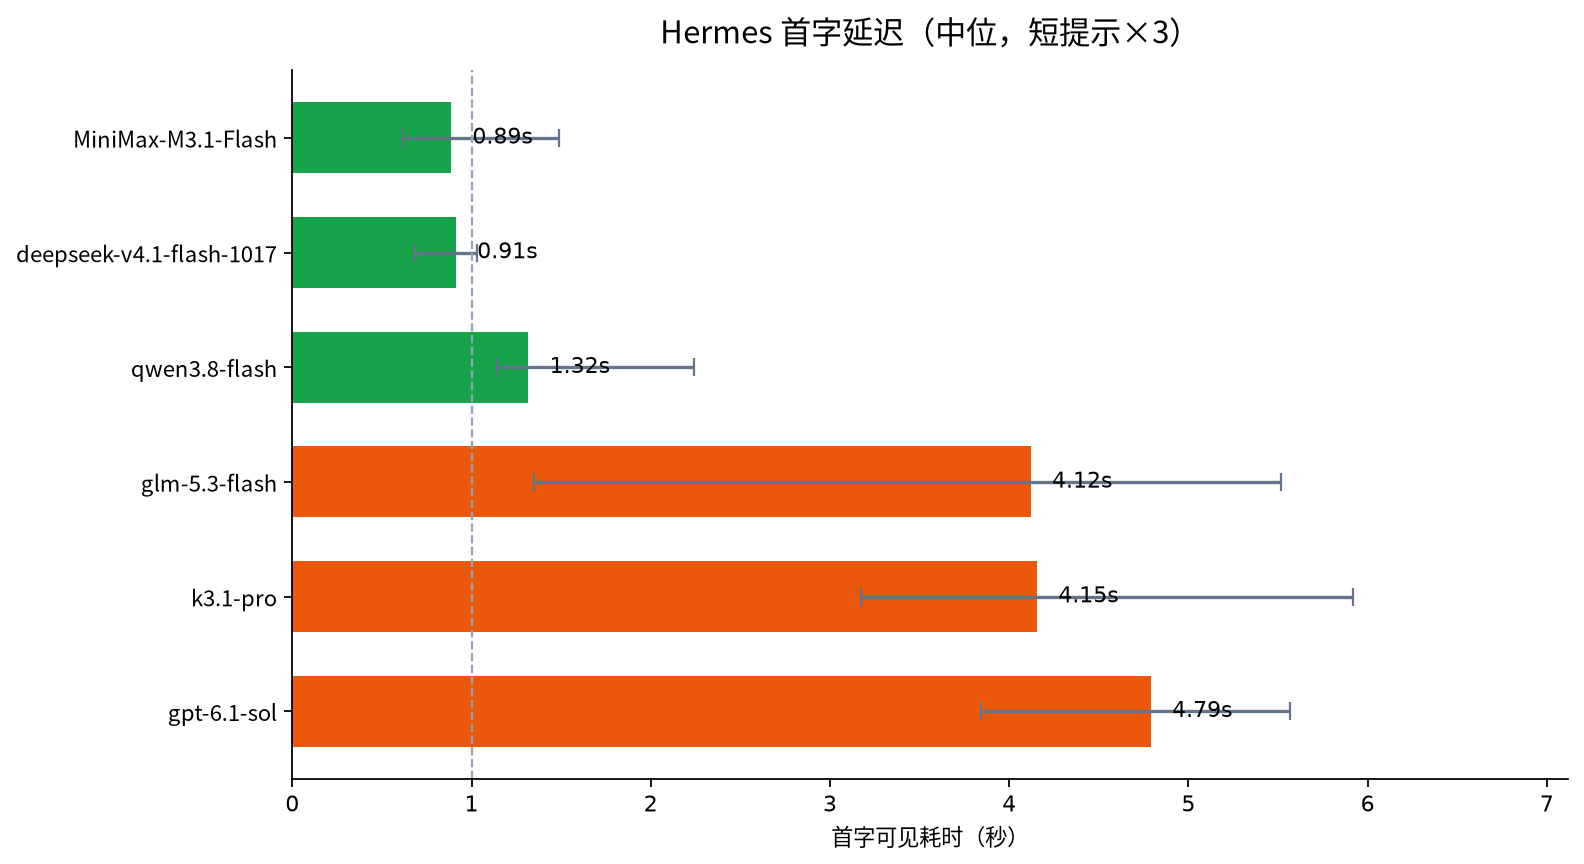
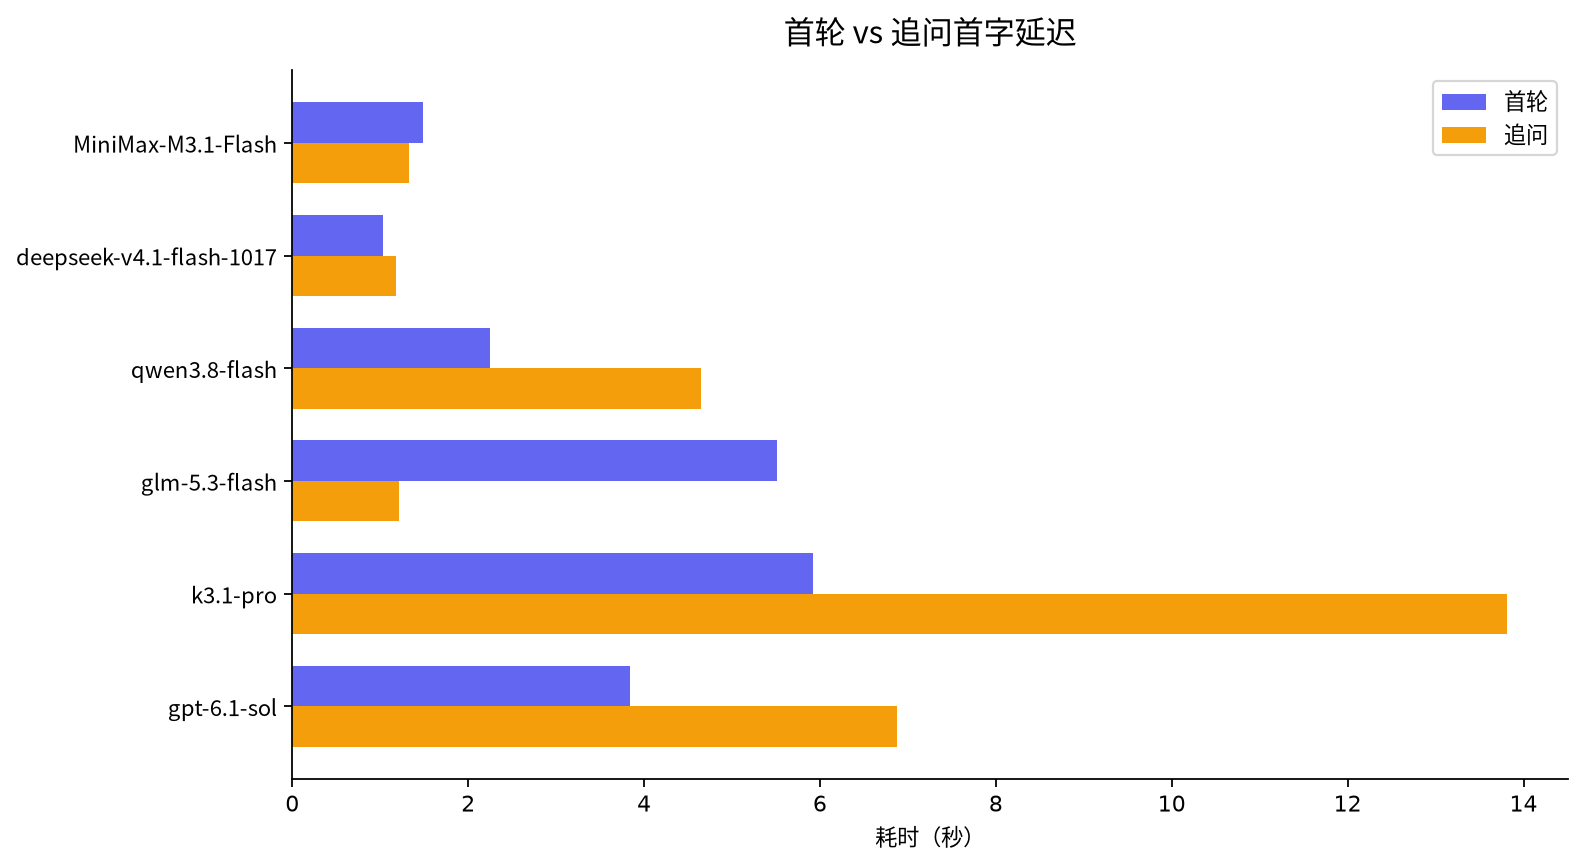
短提示下,MiniMax-M3.1-Flash 与 DeepSeek V4.1 Flash 中位首字都在 1 秒内;Qwen3.8 Flash 约 1.3 秒;GLM、Kimi、GPT-6.1-sol 落在 4–5 秒档。Kimi 追问明显变慢(13.81 秒),GLM 则是首轮慢、追问很快。这是体感延迟,不是智商榜。
昨晚在 Mac Mini 上跑的一轮 Hermes 原生 gateway 首字延迟基准。
环境
Mac Mini。teamlead 配置,原生 Hermes gateway,Hermes 专用 Magpie key,低推理,并带上正常 Hermes 上下文与工具定义。
方法
计时
从 prompt.submit 前一刻起,到第一条非空可见 message.delta。含提示准备、网络、排队和模型推理,不含建会话。思考中指示不计入可见正文。
方法
样本
每个模型独立隐藏会话:相同短提示 ×3,再加 1 次短追问。24 轮全部流式出字,无工具调用;库表核对无模型 fallback。测试会话已关闭并隐藏。
方法
时间
2026-10-27 00:11:08(Asia/Shanghai)。
方法
越短越快。单位:秒。
| 模型 | 中位首字 | 3 次范围 | 首轮 | 追问 |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | 0.89 | 0.61–1.49 | 1.49 | 1.33 |
| DeepSeek V4.1 Flashdeepseek-v4.1-flash-1017 | 0.91 | 0.68–1.03 | 1.03 | 1.18 |
| Qwen3.8 Flashqwen3.8-flash | 1.32 | 1.14–2.24 | 2.24 | 4.65 |
| GLM-5.3 Flashglm-5.3-flash | 4.12 | 1.35–5.51 | 5.51 | 1.21 |
| Kimi k3.1-prok3.1-pro | 4.15 | 3.17–5.92 | 5.92 | 13.81 |
| GPT-6.1-solgpt-6.1-sol | 4.79 | 3.84–5.57 | 3.84 | 6.88 |
1 秒内
两个 Flash 国产路由进 1 秒内:MiniMax-M3.1-Flash 中位 0.89 秒,DeepSeek V4.1 Flash 中位 0.91 秒,体感最接近「秒回」。
看点
GLM
GLM-5.3 Flash 首轮 5.51 秒,追问掉到 1.21 秒。首轮偏慢,缓存或热身后反差大。
看点
Kimi
Kimi k3.1-pro 追问飙到 13.81 秒,短对话场景要小心。
看点
GPT-6.1
GPT-6.1-sol 中位 4.79 秒,三次范围 3.84–5.57 秒,稳定在 4–5 秒档。不算拖后腿,也不抢头条。
看点
样本小、全是短提示。不能代表长上下文、复杂任务或工具链,也不含微信/飞书投递延迟。这是体感延迟,不是智商榜,更不是模型质量排名。
同步自微信公众号「Hobson 小党」· 2026-10-27 · 原发公众号贴图